Der Abruf: was Eiger Vault beim Verlag liest
Technische Seite für das Team, das die Website oder das CMS des Verlags betreibt.
Ein Abruf ist ein Lesevorgang, den Eiger Vault an der vom Verlag gewählten Quelle vornimmt: seiner Website (Feed, Seiten) oder der API seines CMS, die bereits strukturierte Daten liefert. Beim Verlag wird nichts installiert; allenfalls übergibt er uns eine Zugangskennung für seine API. Diese Seite sagt, was wir lesen, in welchem Takt, wie wir uns zu erkennen geben und wie der Verlag uns begrenzen oder abschalten kann.
Die nachstehenden Regeln sind die des Abruf-Connectors, den wir heute betreiben und der Websites und öffentliche APIs liest. Sie gelten für jeden Verlag vorbehaltlich der Anpassungen, die dieser Verlag und wir vereinbaren werden, insbesondere für das Lesen der API eines CMS.
1. Was wir lesen
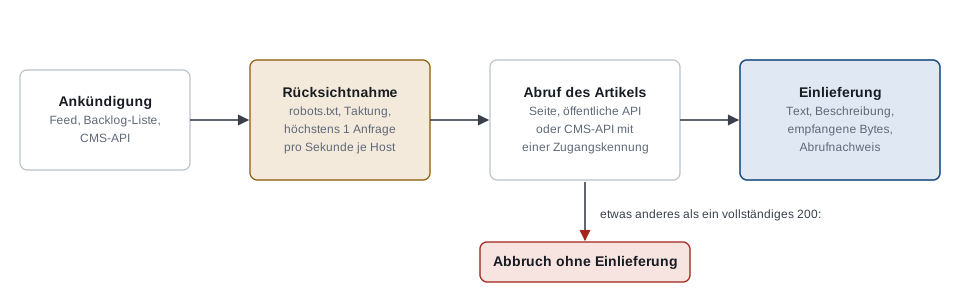
Ein Auslöser, dann der Artikel. Wir lesen zuerst, was die Artikel ankündigt: einen Feed (RSS oder Atom) oder einen öffentlichen Aufruf ohne Geheimnis. Diese Ankündigung ist nur ein Auslöser: Von ihrem Inhalt wird nichts aufbewahrt. Jeder angekündigte Artikel wird anschliessend unter seiner eigenen Adresse gelesen.
Der Artikel: drei Arten, ihn zu lesen. Bietet die Website den Artikel ohne Geheimnis über eine Programmierschnittstelle an, zum Beispiel die REST-API von WordPress, lesen wir den Artikel darüber. Bietet sie nur die Seite an, lesen wir die HTML-Seite. Gewährt uns der Verlag Zugang zur API seines CMS, lesen wir bereits strukturierte Daten – in Blöcke gegliederter Text, vollständige Metadaten –, was erspart, eine Seite zu interpretieren; der Zugang erfolgt mit einer Kennung, die uns der Verlag übergibt und die nur in einem Header der Anfrage übertragen wird. Für jede Quelle sagt unsere Konfiguration, welche dieser Arten wir verwenden; die Felder, die aus der API eines CMS gelesen werden, werden mit dem Verlag vereinbart.
Die Kennung des Artikels. Wir lesen die Kennung, die das CMS dem Artikel gibt, dort, wo sie steht – im Feed, in der Backlog-Liste, im gelesenen Artikel –, und verlangen, dass diese Lesevorgänge dieselbe Zeichenkette ergeben: Weichen sie ab, stoppt der Abruf, und es wird nichts eingeliefert. Wir leiten die Referenz eines Artikels nur dann aus seiner Adresse ab, wenn das CMS keine stabile Kennung hat, und die Konfiguration der Website sagt dies dann ausdrücklich.
Das Backlog. Um die Artikel wiederzufinden, die vor unserem ersten Lesevorgang bereits veröffentlicht waren, durchlaufen wir eine Backlog-Liste, die die Website ohne Geheimnis anbietet – eine Sitemap oder die paginierte Liste einer API –, vom Neuesten zum Ältesten. Wir lesen darin nur die Referenzen, ohne die Artikel zu öffnen. Wir halten an einem für die Quelle vereinbarten Mindestdatum an oder sobald ein ganzer Stapel von Referenzen uns bereits bekannt ist, jenseits eines Mindestfensters der letzten 48 Stunden.
Was wir einliefern. Die Bytes der Antwort, so wie empfangen, nach der Dekodierung einer allfälligen Komprimierung, werden als Ursprungshülle aufbewahrt. Wir leiten daraus einen strukturierten Text und eine Beschreibung ab (Titel, Lead, Autorinnen und Autoren, Daten, Kategorie, kanonische Adresse, Sprache), die ohne Ergänzung übernommen werden: Ein fehlendes Datum bleibt fehlend. Wir liefern weder Bilder noch Videos ein, die auf einer Seite gelesen werden, weil sie oft von Agenturen stammen, unter anderen Rechten als der Text. Bezeichnet der Artikel eindeutig das Original, dessen Übersetzung er ist, deklarieren wir dies als Beziehung; andernfalls wird keine Beziehung deklariert.
Der Abrufnachweis. Jeder abgerufene Artikel wird mit einem Nachweis eingeliefert: die nach Weiterleitungen gelesene Endadresse, der Zeitpunkt des Abrufs, der Hashwert der empfangenen Bytes und die TLS-Zertifikatskette, die Ihr Server vorgelegt hat. Unser Vault prüft, dass die Adresse https ist, dass die Kette auf eine anerkannte Zertifizierungsstelle zurückgeht, dass das Zertifikat den Namen des Servers abdeckt und dass es zum Zeitpunkt des Abrufs gültig war. Dieser Nachweis bestätigt die Kontrolle über den Domainnamen zu diesem Zeitpunkt, nicht mehr: Er ist keine Signatur des Verlags.
2. In welchem Takt
Diese Werte sind Startwerte, die nach Messungen angepasst werden.
| Was | Takt |
|---|---|
| Lesen des Feeds jeder Quelle | alle 15 Minuten |
| Durchlauf des Backlogs | beim Start des Connectors, danach alle 24 Stunden; nie zwei Durchläufe gleichzeitig für eine Quelle |
| Mindestfenster des Backlogs | die jüngsten 48 Stunden werden immer neu gelesen |
| Durchsatz zu einem selben Host | höchstens 1 Anfrage pro Sekunde, und weniger, wenn das Crawl-delay Ihrer robots.txt einen längeren Abstand verlangt |
Lesen Ihrer robots.txt |
höchstens 24 Stunden zwischengespeichert; ist sie nicht erreichbar, nach 15 Minuten neu versucht |
| Anzahl der Abrufe eines Artikels | höchstens 3 pro Durchlauf, nach einer gescheiterten Einlieferung |
Kündigt eine Quelle ein Embargo an, rufen wir den Artikel erst nach dessen Aufhebung ab, unter seiner Adresse. Diese Regel ist noch nicht in Betrieb.
3. Wie wir uns identifizieren
Jede Anfrage trägt einen User-Agent-Header, der den Connector nennt und eine Kontaktadresse angibt. Derjenige unserer Testumgebung hat die Form EigerVaultTrialConnector/1 (+https://eigervault.ch; contact@eigervault.ch); der Verlag, der uns einen Abruf erlaubt, erhält von uns die genaue Kennung, die er erkennen muss.
Wir senden nur vier Header: User-Agent, Accept, Accept-Encoding: identity und, falls der Verlag uns für eine Quelle einen gegeben hat, einen einzigen Zugangs-Header mit einer Kennung, die uns der Verlag übergeben hat. Wir senden keine Cookies und behalten keine von einer Anfrage zur nächsten.
Wir lesen nur über https. Wir entfernen aus einer Adresse, was als Parameter hinzukommt (Kampagnen-Tracking, Sitzungskennungen), ausser den Parametern, die die Konfiguration der Quelle als notwendig deklariert. Eine Weiterleitung wird nur zu https und zu einer Domain verfolgt, die der Verlag für die Quelle zugelassen hat, innerhalb einer Grenze an Weiterleitungen; eine Weiterleitung auf eine Adresse, die einen nicht deklarierten Parameter hinzufügt, stoppt den Abruf. Wir öffnen keine Verbindung zu einer IP-Adresse, die nicht öffentlich ist. Die Dauer jeder Anfrage und die Grösse der Antwort sind begrenzt.
4. Wie der Verlag uns begrenzt oder abschaltet
Über die robots.txt, bei einer Website. Wir lesen sie auf jedem Host vor jeder anderen Anfrage an diesen Host und wenden die Regelgruppe an, die uns nennt (oder, fehlt sie, die allgemeine Gruppe), gemäss RFC 9309. Eine Sperre gilt für den Feed, die Backlog-Liste und die Artikel. Antwortet die Datei mit einem 4xx-Fehler, betrachten wir sie als nicht vorhanden und lesen frei; antwortet sie mit einem 5xx-Fehler oder ist nicht erreichbar, lesen wir nichts, bis sie antwortet. Ein Crawl-delay verlängert den Abstand zwischen zwei Anfragen. Ein Disallow auf unseren Namen ist das einfachste Mittel, uns abzuschalten, ohne uns zu benachrichtigen.
Über die HTTP-Codes. Nur eine endgültige Antwort mit Status 200, vollständig empfangen, wird eingeliefert. Jede andere Antwort – 403, 404, 429, 5xx, abgeschnittene Antwort, unbekannte Komprimierung, fehlender Medientyp – stoppt den Abruf dieses Artikels, ohne etwas einzuliefern. Wir versuchen es beim nächsten Durchlauf erneut, höchstens dreimal je Artikel und Durchlauf. Nach zehn aufeinanderfolgenden gescheiterten Einlieferungen stoppt der Durchlauf der Quelle; dies betrifft unsere eigenen gescheiterten Einlieferungen, nicht diejenigen Ihrer Website.
Über die API eines CMS. Der Verlag schaltet uns ab, indem er die Zugangskennung widerruft, die er uns übergeben hat, oder indem er den Durchsatz seiner API begrenzt: Jede andere Antwort als ein vollständiger Erfolg stoppt den Abruf, ohne etwas einzuliefern, wie oben.
Indem er uns schreibt. Der Verlag kann Eiger Vault bitten, den Abruf einzustellen: Der Operator deaktiviert die Quelle oder widerruft den Connector-Schlüssel; jede folgende Einlieferung wird abgelehnt. Eine Deaktivierung wirkt nur auf die Zukunft: Was bereits versiegelt ist, ändert sich nicht. Um einen bereits empfangenen Inhalt zurückzunehmen, siehe Eiger Vault für Verlage: Überblick, Abschnitt 3.
Über das Netz. Wir rufen nur die Domains ab, die der Verlag für die Quelle zugelassen hat. Wir veröffentlichen derzeit keinen Bereich von Absender-IP-Adressen.