La lettura: ciò che Eiger Vault legge presso l'editore
Pagina tecnica, per il team che gestisce il sito o il CMS dell'editore.
Una lettura è un accesso in lettura che Eiger Vault effettua nella fonte scelta dall'editore: il suo sito web (feed, pagine) oppure l'API del suo CMS, che restituisce dati già strutturati. Presso l'editore non si installa nulla; al massimo, ci consegna un identificativo d'accesso alla sua API. Questa pagina dice che cosa leggiamo, con quale cadenza, come ci annunciamo e come l'editore può limitarci o interromperci.
Le regole qui sotto sono quelle del connettore di lettura che gestiamo oggi, che legge siti web e API pubbliche. Valgono per ogni editore, fatti salvi gli adattamenti che l'editore e noi avremo concordato, in particolare per la lettura dell'API di un CMS.
1. Che cosa leggiamo
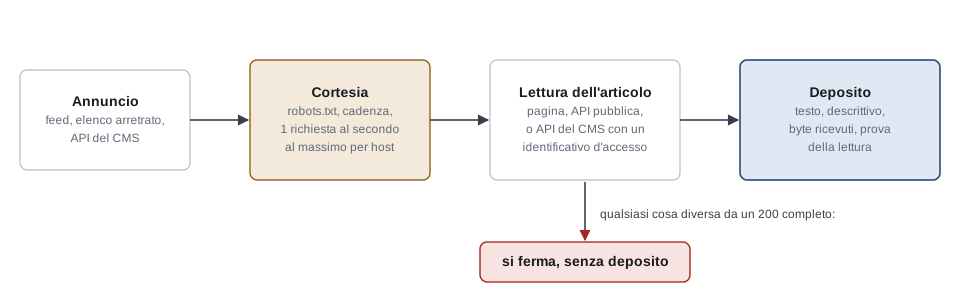
Un innesco, poi l'articolo. Leggiamo anzitutto ciò che annuncia gli articoli: un feed (RSS o Atom), oppure una chiamata pubblica senza segreto. Questo annuncio è solo un innesco: nulla del suo contenuto viene conservato. Ogni articolo annunciato viene poi letto al proprio indirizzo.
L'articolo: tre modi di leggerlo. Quando il sito offre l'articolo senza segreto tramite un'interfaccia di programmazione, per esempio l'API REST di WordPress, leggiamo l'articolo tramite essa. Quando offre solo la pagina, leggiamo la pagina HTML. Quando l'editore ci dà accesso all'API del suo CMS, leggiamo dati già strutturati – testo suddiviso in blocchi, metadati completi –, il che evita di interpretare una pagina; l'accesso avviene con un identificativo che l'editore ci consegna e che passa solo in un'intestazione della richiesta. Per ogni fonte, la nostra configurazione indica quale di questi modi usiamo; i campi letti nell'API di un CMS si concordano con l'editore.
L'identificativo dell'articolo. Leggiamo l'identificativo che il CMS assegna all'articolo là dove si trova – nel feed, nell'elenco dell'arretrato, nell'articolo letto –, ed esigiamo che queste letture diano la stessa stringa: se differiscono, la lettura si ferma e non viene depositato nulla. Ricaviamo il riferimento di un articolo dal suo indirizzo solo se il CMS non ha alcun identificativo stabile, e in tal caso la configurazione del sito lo dice espressamente.
L'arretrato. Per ritrovare gli articoli già pubblicati prima della nostra prima lettura, percorriamo un elenco dell'arretrato che il sito offre senza segreto – una mappa del sito (sitemap) o l'elenco paginato di un'API –, dal più recente al più vecchio. Vi leggiamo solo i riferimenti, senza aprire gli articoli. Ci fermiamo a una data limite concordata per la fonte, oppure appena un intero lotto di riferimenti ci è già noto, oltre una finestra minima delle ultime 48 ore.
Che cosa depositiamo. I byte della risposta così come ricevuti, dopo la decodifica di un'eventuale compressione, sono conservati come involucro d'origine. Ne ricaviamo un testo strutturato e un descrittivo (titolo, occhiello, autori, date, categoria, indirizzo canonico, lingua), copiati senza completare nulla: una data assente resta assente. Non depositiamo né immagini né video letti da una pagina, perché spesso provengono da agenzie, con diritti diversi da quelli del testo. Se l'articolo designa senza ambiguità l'originale di cui è la traduzione, lo dichiariamo come relazione; altrimenti non viene dichiarata alcuna relazione.
La prova della lettura. Ogni articolo letto è depositato con una prova: l'indirizzo finale letto dopo i reindirizzamenti, l'istante della lettura, l'impronta dei byte ricevuti e la catena di certificati TLS che il vostro server ha presentato. Il nostro vault verifica che l'indirizzo sia in https, che la catena risalga a un'autorità di certificazione riconosciuta, che il certificato copra il nome del server e che fosse valido all'istante della lettura. Questa prova attesta il controllo del nome di dominio in quell'istante, nulla di più: non è una firma dell'editore.
2. Con quale cadenza
Questi valori sono valori iniziali, adeguati dopo misurazione.
| Che cosa | Cadenza |
|---|---|
| Lettura del feed di ogni fonte | ogni 15 minuti |
| Scansione dell'arretrato | all'avvio del connettore, poi ogni 24 ore; mai due passaggi contemporanei per una fonte |
| Finestra minima dell'arretrato | le 48 ore più recenti vengono sempre rilette |
| Frequenza verso uno stesso host | al massimo 1 richiesta al secondo, e meno se il Crawl-delay del vostro robots.txt richiede un intervallo più lungo |
Lettura del vostro robots.txt |
conservato al massimo 24 ore; se è irraggiungibile, riprovato dopo 15 minuti |
| Numero di letture di un articolo | al massimo 3 per passaggio, dopo un deposito fallito |
Quando una fonte annuncerà un embargo, leggeremo l'articolo solo dopo la sua revoca, al suo indirizzo. Questa regola non è ancora in servizio.
3. Come ci identifichiamo
Ogni richiesta porta un'intestazione User-Agent che nomina il connettore e dà un indirizzo di contatto. Quella del nostro ambiente di prova ha la forma EigerVaultTrialConnector/1 (+https://eigervault.ch; contact@eigervault.ch); l'editore che ci autorizza a una lettura riceverà da noi l'identificativo esatto da riconoscere.
Inviamo solo quattro intestazioni: User-Agent, Accept, Accept-Encoding: identity e, se l'editore ce ne ha dato uno per una fonte, un'unica intestazione d'accesso che porta un identificativo consegnatoci dall'editore. Non inviamo alcun cookie e non ne conserviamo alcuno da una richiesta all'altra.
Leggiamo solo in https. Rimuoviamo da un indirizzo ciò che vi si aggiunge come parametri (tracciamento di campagna, identificativi di sessione), eccetto i parametri che la configurazione della fonte dichiara necessari. Un reindirizzamento è seguito solo verso https e verso un dominio che l'editore ha ammesso per la fonte, entro un limite di reindirizzamenti; un reindirizzamento verso un indirizzo che aggiunge un parametro non dichiarato ferma la lettura. Ci rifiutiamo di aprire una connessione verso un indirizzo IP non pubblico. La durata di ogni richiesta e la dimensione della risposta sono limitate.
4. Come l'editore ci limita o ci interrompe
Tramite il robots.txt, per un sito web. Lo leggiamo su ogni host prima di qualsiasi altra richiesta verso quell'host e applichiamo il gruppo di regole che ci nomina (o, in mancanza, il gruppo generale), secondo la RFC 9309. Un divieto vale per il feed, per l'elenco dell'arretrato e per gli articoli. Se il file risponde con un errore 4xx, lo consideriamo assente e leggiamo liberamente; se risponde con un errore 5xx, o non è raggiungibile, non leggiamo nulla finché non risponde. Un Crawl-delay allunga l'intervallo tra due richieste. Un Disallow a nostro nome è il modo più semplice per interromperci, senza avvisarci.
Tramite i codici HTTP. Solo una risposta finale con stato 200, ricevuta per intero, viene depositata. Qualsiasi altra risposta – 403, 404, 429, 5xx, risposta troncata, compressione sconosciuta, tipo di media assente – ferma la lettura di quell'articolo senza depositare nulla. Riproviamo al passaggio successivo, al massimo tre volte per articolo e per passaggio. Dopo dieci fallimenti di deposito consecutivi, il passaggio della fonte si ferma; ciò riguarda i nostri fallimenti di deposito, non quelli del vostro sito.
Tramite l'API di un CMS. L'editore ci interrompe revocando l'identificativo d'accesso che ci ha consegnato, oppure limitando la frequenza della sua API: qualsiasi risposta diversa da un successo completo ferma la lettura senza depositare nulla, come sopra.
Scrivendoci. L'editore può chiedere a Eiger Vault di cessare la lettura: l'operatore disattiva la fonte, oppure revoca la chiave del connettore; ogni deposito successivo è rifiutato. Una disattivazione agisce solo sul futuro: ciò che è già sigillato non cambia. Per ritirare un contenuto già ricevuto, vedi Eiger Vault per gli editori: panoramica, §3.
Tramite la rete. Leggiamo solo i domini che l'editore ha ammesso per la fonte. Al momento non pubblichiamo un intervallo di indirizzi IP di provenienza.