La relève: ce qu'Eiger Vault lit chez l'éditeur
Page technique, pour l'équipe qui exploite le site ou le CMS de l'éditeur.
Une relève est une lecture que fait Eiger Vault, à la source que l'éditeur choisit: son site web (flux, pages), ou l'API de son CMS, qui rend des données déjà structurées. Rien n'est installé chez l'éditeur; au plus, il nous remet un identifiant d'accès à son API. Cette page dit ce que nous lisons, à quel rythme, comment nous nous annonçons, et comment l'éditeur peut nous limiter ou nous couper.
Les règles ci-dessous sont celles du connecteur de relève que nous exploitons aujourd'hui, qui lit des sites web et des API publiques. Elles valent pour chaque éditeur sous réserve des ajustements que cet éditeur et nous aurons convenus, en particulier pour la lecture de l'API d'un CMS.
1. Ce que nous lisons
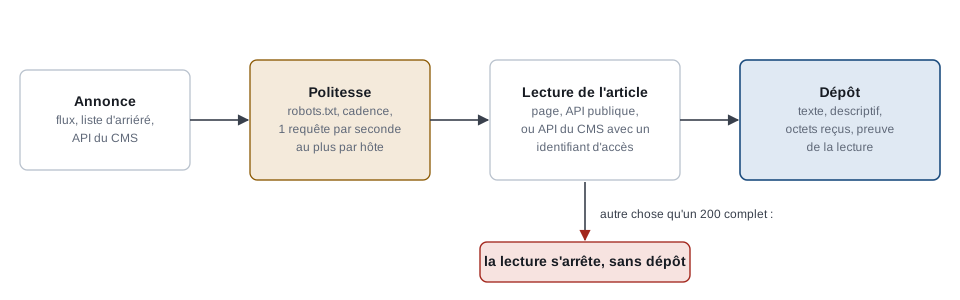
Un déclencheur, puis l'article. Nous lisons d'abord ce qui annonce les articles: un flux (RSS ou Atom), ou un appel public sans secret. Cette annonce n'est qu'un déclencheur: rien de son contenu n'est conservé. Chaque article annoncé est ensuite lu à sa propre adresse.
L'article: trois façons de le lire. Quand le site offre l'article sans secret par une interface de programmation, par exemple l'API REST de WordPress, nous lisons l'article par elle. Quand il n'offre que la page, nous lisons la page HTML. Quand l'éditeur nous donne accès à l'API de son CMS, nous lisons des données déjà structurées – texte découpé en blocs, métadonnées complètes –, ce qui évite d'interpréter une page; l'accès se fait avec un identifiant que l'éditeur nous remet, et qui ne passe que dans un en-tête de la requête. Pour chaque source, notre configuration dit laquelle de ces façons nous utilisons; les champs lus dans l'API d'un CMS se conviennent avec l'éditeur.
L'identifiant de l'article. Nous lisons l'identifiant que le CMS donne à l'article là où il se trouve – dans le flux, dans la liste d'arriéré, dans l'article lu –, et nous exigeons que ces lectures donnent la même chaîne: si elles diffèrent, la relève s'arrête et rien n'est déposé. Nous ne tirons la référence d'un article de son adresse que si le CMS n'a aucun identifiant stable, et la configuration du site le dit alors expressément.
L'arriéré. Pour retrouver les articles déjà publiés avant notre première lecture, nous parcourons une liste d'arriéré que le site offre sans secret – un plan de site (sitemap) ou la liste paginée d'une API –, du plus récent au plus ancien. Nous n'y lisons que les références, sans ouvrir les articles. Nous nous arrêtons à une date plancher convenue pour la source, ou dès qu'un lot entier de références est déjà connu de nous au-delà d'une fenêtre minimale des 48 dernières heures.
Ce que nous déposons. Les octets de la réponse tels que reçus, après décodage d'une éventuelle compression, sont conservés comme enveloppe d'origine. Nous en tirons un texte structuré et un descriptif (titre, chapeau, auteurs, dates, catégorie, adresse canonique, langue), recopiés sans rien compléter: une date absente reste absente. Nous ne déposons ni image ni vidéo lues sur une page, parce qu'elles viennent souvent d'agences, sous d'autres droits que le texte. Si l'article désigne sans ambiguïté l'original dont il est la traduction, nous le déclarons comme relation; sinon, aucune relation n'est déclarée.
La preuve de la lecture. Chaque article relevé est déposé avec une preuve: l'adresse finale lue après redirections, l'instant de la lecture, l'empreinte des octets reçus, et la chaîne de certificats TLS que votre serveur a présentée. Notre vault contrôle que l'adresse est en https, que la chaîne remonte à une autorité de certification reconnue, que le certificat couvre le nom du serveur et qu'il était valide à l'instant de la lecture. Cette preuve atteste le contrôle du nom de domaine à cet instant, rien de plus: ce n'est pas une signature de l'éditeur.
2. À quel rythme
Ces valeurs sont des valeurs de départ, ajustées après mesure.
| Quoi | Rythme |
|---|---|
| Lecture du flux de chaque source | toutes les 15 minutes |
| Parcours de l'arriéré | au démarrage du connecteur, puis toutes les 24 heures; jamais deux passages à la fois pour une source |
| Fenêtre minimale d'arriéré | les 48 heures les plus récentes sont toujours relues |
| Débit vers un même hôte | au plus 1 requête par seconde, et moins si le Crawl-delay de votre robots.txt demande un intervalle plus long |
Lecture de votre robots.txt |
gardé au plus 24 heures; s'il est injoignable, retenté au bout de 15 minutes |
| Nombre de lectures d'un article | au plus 3 par passage, après un dépôt qui a échoué |
Quand une source annoncera un embargo, nous ne relèverons l'article qu'après sa levée, à son adresse. Cette règle n'est pas encore en service.
3. Comment nous nous identifions
Chaque requête porte un en-tête User-Agent qui nomme le connecteur et donne une adresse de contact. Celui de notre environnement d'essai est de la forme EigerVaultTrialConnector/1 (+https://eigervault.ch; contact@eigervault.ch); l'éditeur qui nous autorise une relève recevra de nous l'identifiant exact à reconnaître.
Nous n'envoyons que quatre en-têtes: User-Agent, Accept, Accept-Encoding: identity, et, si l'éditeur nous en a donné un pour une source, un unique en-tête d'accès portant un identifiant que l'éditeur nous a remis. Nous n'envoyons aucun cookie et n'en gardons aucun d'une requête à l'autre.
Nous ne lisons qu'en https. Nous retirons d'une adresse ce qui s'y ajoute en paramètres (suivi de campagne, identifiants de session), sauf les paramètres que la configuration de la source déclare nécessaires. Une redirection n'est suivie que vers https et vers un domaine que l'éditeur a admis pour la source, dans une limite de redirections; une redirection vers une adresse qui ajoute un paramètre non déclaré arrête la lecture. Nous refusons d'ouvrir une connexion vers une adresse IP qui n'est pas publique. La durée de chaque requête et la taille de la réponse sont bornées.
4. Comment l'éditeur nous limite, ou nous coupe
Par le robots.txt, pour un site web. Nous le lisons sur chaque hôte avant toute autre requête vers cet hôte, et nous appliquons le groupe de règles qui nous nomme (ou, à défaut, le groupe général), selon le RFC 9309. Une interdiction vaut pour le flux, la liste d'arriéré et les articles. Si le fichier répond par une erreur 4xx, nous le tenons pour absent et nous lisons librement; s'il répond par une erreur 5xx, ou n'est pas joignable, nous ne lisons rien tant qu'il ne répond pas. Un Crawl-delay allonge l'intervalle entre deux requêtes. Un Disallow à notre nom est le moyen le plus simple de nous couper, sans nous prévenir.
Par les codes HTTP. Seule une réponse finale de statut 200, reçue en entier, est déposée. Toute autre réponse – 403, 404, 429, 5xx, réponse tronquée, compression inconnue, type de média absent – arrête la lecture de cet article sans rien déposer. Nous réessayons au passage suivant, trois fois au plus par article et par passage. Après dix échecs de dépôt d'affilée, le passage de la source s'arrête; cela concerne nos propres échecs de dépôt, pas ceux de votre site.
Par l'API d'un CMS. L'éditeur nous coupe en révoquant l'identifiant d'accès qu'il nous a remis, ou en limitant le débit de son API: toute réponse autre qu'un succès complet arrête la lecture sans rien déposer, comme ci-dessus.
En nous écrivant. L'éditeur peut demander à Eiger Vault de cesser la relève: l'opérateur désactive la source, ou révoque la clé de connecteur; tout dépôt suivant est refusé. Une désactivation n'agit que sur l'avenir: ce qui est déjà scellé ne change pas. Pour retirer un contenu déjà reçu, voir Eiger Vault pour les éditeurs: vue d'ensemble, §3.
Par le réseau. Nous ne relevons que les domaines que l'éditeur a admis pour la source. Nous ne publions pas, à ce jour, de plage d'adresses IP de départ.